딥러닝에서 복잡한 문제를 해결하기 위해서는 보통 사용자가 여러개의 레이러를 쌓는다
이렇게 복잡한 레이어가 쌓였을 경우 발생하는 대표적인 문제가 기울기 사라짐 (Gradient Vanishing)이다
뉴럴넷 학습에서는 오차 역전파 방법을 사용한다
오차 역전파는 필연적으로 과거 사용된 활성화 함수의 도함수가 여러번 곱해지게 된다. 이때 만약 시그모이드와 같은 활성화 함수를 상ㅇ헀다면, 필연적으로 기울기 사라짐 문제가 발생한다
시그 모이드의 함수 그래프를 보면 위와 같이 생겼고, 도함수는 우측과 같다. 도함수의 값은 0~1/4 사이 값을 가지게 된다 이런 도함수 값이 거듭해서 곱해지게 될 경우 필연적으로 0으로 값이 수렴하게 된다. 따라서 오차으 그라디언트 값은 (dE/dw)은 0이 되어 가중치를 더 이상 업데이트가 되지 않는 현상이 발생한다. 이런 현상은 활서오하 함수의 도함수가 여러번 곱해지는 input layer 근방에서 더 크게 나타나게 된다
이 문제는 활성화 함수을 변경해 어느 정도 막을 수 있다
ReLU 함수는 도함수 값이 0 또는 1로 결정이 되게 됩니다. 오차를 앞레이어에 전달하지 않거나 100% 전달하거나 둘중 하나로 학습이 진행되기 떄문에 거듭 곱해진다고해서 다행이 Sigmoid와 같이 Gradient Vanishing 문제가 필연적으로 발생하지 않습니다. 하지만, 희박한 확률이지만 특정 layer에서 모든 퍼셉트론들의 도함수 값이 0이 되어버려 Gradient Vanishing이 발생할 수 있습니다. (이 문제를 개선한 Leaky ReLU와 같은 함수도 존재합니다)
이런 이유로 일반적으로 Hidden Layer에서는 활성화 함수로 ReLU계열을 사용하고 마지막 Output Layer에서만 Sigmoid와 같이 목적에 맞는 활성화 함수를 사용합니다.
오버피팅(Overfitting)과 정규화(Regularization)
딥러닝에서 가장 흔하게 나타나고 해결하기 어려운 문제는 오버피팅(Overfitting)입니다.
언더, 오버피팅(Overfitting)에 대해 설명하고, 이 현상을 막기 위한 대표적인 3가지 방법 Early Stop, Weight decay, Dropout에 대해서 소개하겠습니다.
언더피팅(Underfitting), 오버피팅(Overfitting)
지도 학습 딥러닝 모델(Supervised Deep Learning)의 목표는 주어진 데이터를 이용해 데이터를 잘 설명하는 모델을 만들고, 만들어진 모델을 이용해서 학습하지 않은 데이터에서도 예측력이 우수한 모델을 만드는 것이 목표입니다. 이를 위해서 우리는 Gradient descent를 이용해서 예측값(Prediction)과 현상(Label)간의 오차(Loss)를 최대한 줄이는 방법을 이용하여 학습(Training)하였습니다.
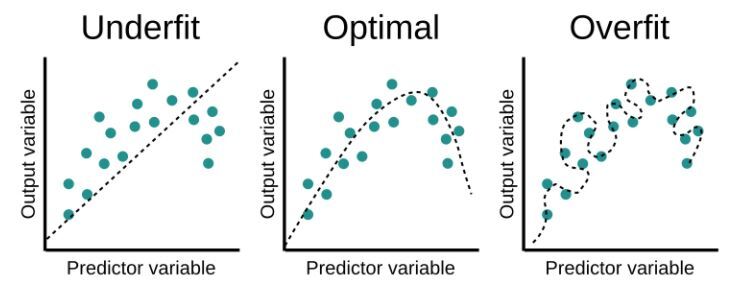
딥러닝 학습에 사용한 신경망 구조가 너무 단순(too simple)해서 Training 데이터와 Test 데이터 모두를 설명하고 예측하지 못하는 경우를 우리는 언더피팅 현상이라고 합니다.
반면에 딥러닝 학습에 복잡한 모델(too complex)을 사용하면 Training 데이터에 대해서는 정확히 설명할 수 있으나, Test데이터의 예측력은 매우 떨어지게 됩니다.
이런 케이스를 Overfitting이라고 합니다.
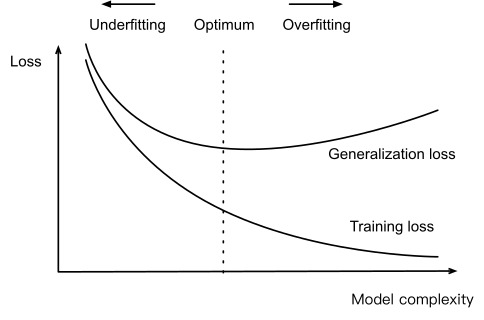
Underfitting문제의 솔루션은 (주어진 데이터를 더 잘 설명하는) 적당한 모델을 선택/개발하는 방법과 학습을 더 많이하는 방법이 있습니다.
하지만 이미 충분히 복잡한 신경망에서 나타나는 Overfitting 문제의 해결을 위해서는 기존 학습 알고리즘에 여러가지 정규화(Regularization)방법을 추가해서 해결 합니다.
얼리 스탑(Early stopping)
오버피팅을 막는 가장 손쉬운 방법입니다.
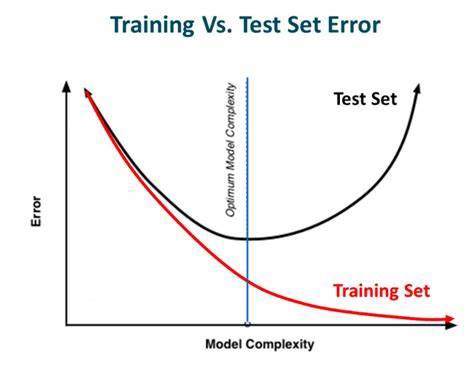
트레이닝 세트에 가중치가 최적화 되기 이전에 학습을 조기종료 시키는 방법입니다. 물론 가중치 업데이트에 테스트 세트를 포함시키지 않고 에러 모니터링만 합니다. 테스트셋의 학습이 진행될수록 사용자가 지정한 횟수(ex, 5회)동안 로스가 상승한다면 오버핏이 나타난다고 간주하고 학습을 중지합니다.
Weight decay
로스펑션에 추가적인 패널티 텀을 붙여서 로스펑션을 수정하여 학습하는 방법입니다.
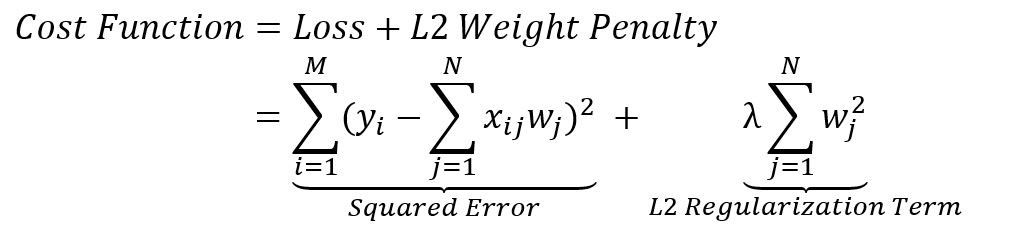
보통은 L2 Regularization을 사용하니 L2를 기준으로 설명드리겠습니다.
첫번째 E(W)의 식은 앞서 설명드린것과 같이 Label과 Prediction과의 Error를 최소화되도록 학습이 진행되고 뒤의 λ*(W^2)는 가중치의 L2 norm을 최소화 하라는 말과 같습니다.
모순적인 요구조건이 두가지로 섞여 있습니다. 일반적으로 가중치의 L2 norm을 최소화하면 Error는 상승하고, Error를 최소화하면 L2 norm의 값은 상승하게 됩니다.
정리하면, 두가지 요구사항 가중치의 L2 norm과 Error를 합쳤을때 최소화하는 적당한(?) 가중치를 찾으라는 요구조건으로 해석할 수 있습니다.
이러한 요구조건을 만족시키면 뉴럴넷은 Training data에 최적화된 가중치가 아니라 모든 퍼셉트론의 가중치가 일정 수준 이상을 가지는 균형적인 가중치로 학습이 됩니다.
Dropout
랜덤 포레스트의 앙상블과 매우 유사한 방법입니다.
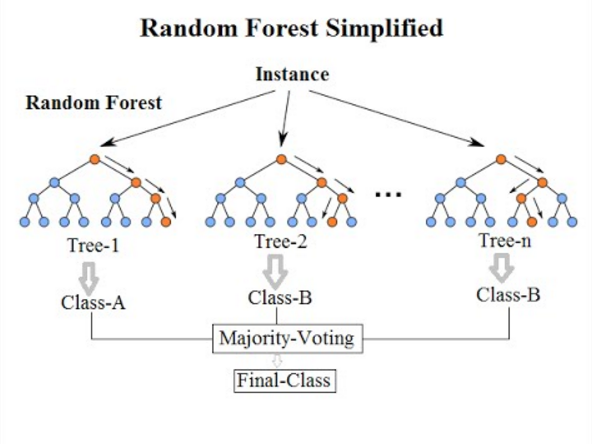
랜덤 포레스트는 서로 다른 Feature를 랜덤으로 선택하고 만들어진 Decision Tree들의 앙상블로 결과값을 예측하는 모델입니다.
뉴럴넷의 Dropout도 이것과 매우 흡사한 방법입니다.
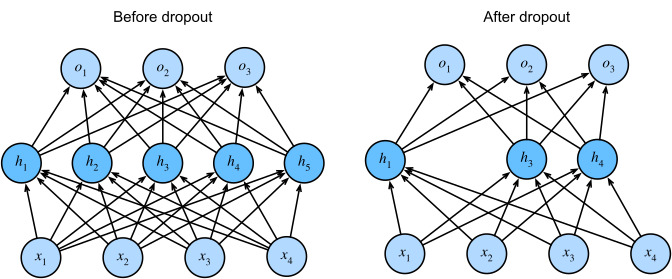
미니 배치마다 히든 레이어에서 임의의 노드들을 랜덤으로 선택해서 학습을 진행합니다.
남겨진 퍼셉트론과 연결된 가중치는 drop안할 때보다 더 강한 가중치 값을 가지게 됩니다.
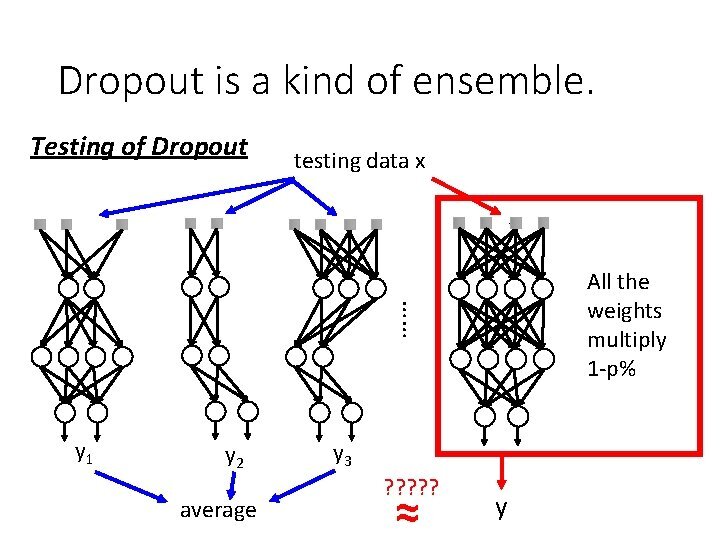
하지만, 실제 테스트(inference)시에는 drop하지 않고 모든 가중치에 (1-drop_rate)%를 곱해 전체 가중치를 한번 스케일링하여 Prediction합니다.
참고 자료
'Machine-Learning > Basic' 카테고리의 다른 글
| [ML] k-최근접 이웃 (K-Nearest Neighbor) (0) | 2022.11.19 |
|---|---|
| [ML] SVM(Support Vertor Machine) (0) | 2022.09.26 |
| [ML] 활성화 함수 (Activation function) (0) | 2021.09.05 |
| [ML] 손실함수(Loss function) (0) | 2021.09.05 |
| [ML] 경사하강법(Gradient Descent) (0) | 2021.09.05 |


댓글