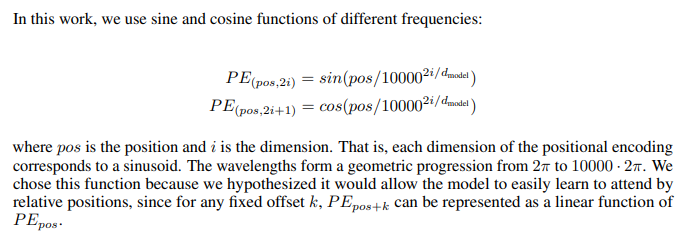
Positional Encoding : Transformer은 Sequence한 CNN와 RNN을 사용하지 않기 때문에 순서 정보를 지정해야 한다
네트워크는 문장을 완전히 이해하기 위해 문장을 단어 단위로 나누어 입력한다. 하지만 트랜스포머 네트워크는 위와 같은 순환 구조를 따르지 않는다. 단어 단위로 문장을 입력하는 대신에 문장 안에 있는 모든 단어를 병렬 (parallel) 형태로 입력한다. 병렬로 단어를 입력하는 것은 학습 시간을 줄이고 RNN의 장기 의존성 문제를 해결하는데 도움이 된다.
하지만 트랜스포머에서 단어를 병렬로 입력하면 한가지 문제가 발생한다. 그것은 바로 순서 정보가 유지되지 않은 상태에서 문장의 의미를 어떻게 이해할 수 있느냐는 점이다. 문장의 의미를 이해하기 위해서는 단어의 순서가 매우 중요하다
문장의 의미를 명확히 이해하려면 단어의 위치 정보를 반드시 이해하야 한다
- 각 위치 별로 유일한 벡터 값
- 서로 다른 길이의 시퀀스에 대해서도 적용이 가능
- 서로 다른 길이의 시퀀스 두 인덱스 간의 거리는 일정
참고자료
https://gaussian37.github.io/dl-concept-positional_encoding/
'Machine-Learning > NLP (Natural Language Processing)' 카테고리의 다른 글
| [NLP] 멀티 헤드 어텐션(multi-head attention) 원리 (2) | 2022.11.06 |
|---|---|
| [NLP] Transforemr - 피드포워드, add와 Norm (0) | 2022.11.06 |
| [NLP] Transformer - positional encoding, self-attention (0) | 2022.10.11 |
| [NLP] Transformer-Overview (0) | 2022.10.11 |
| [NLP] Seq2Seq (0) | 2022.10.04 |


댓글